티스토리 뷰
Hash table
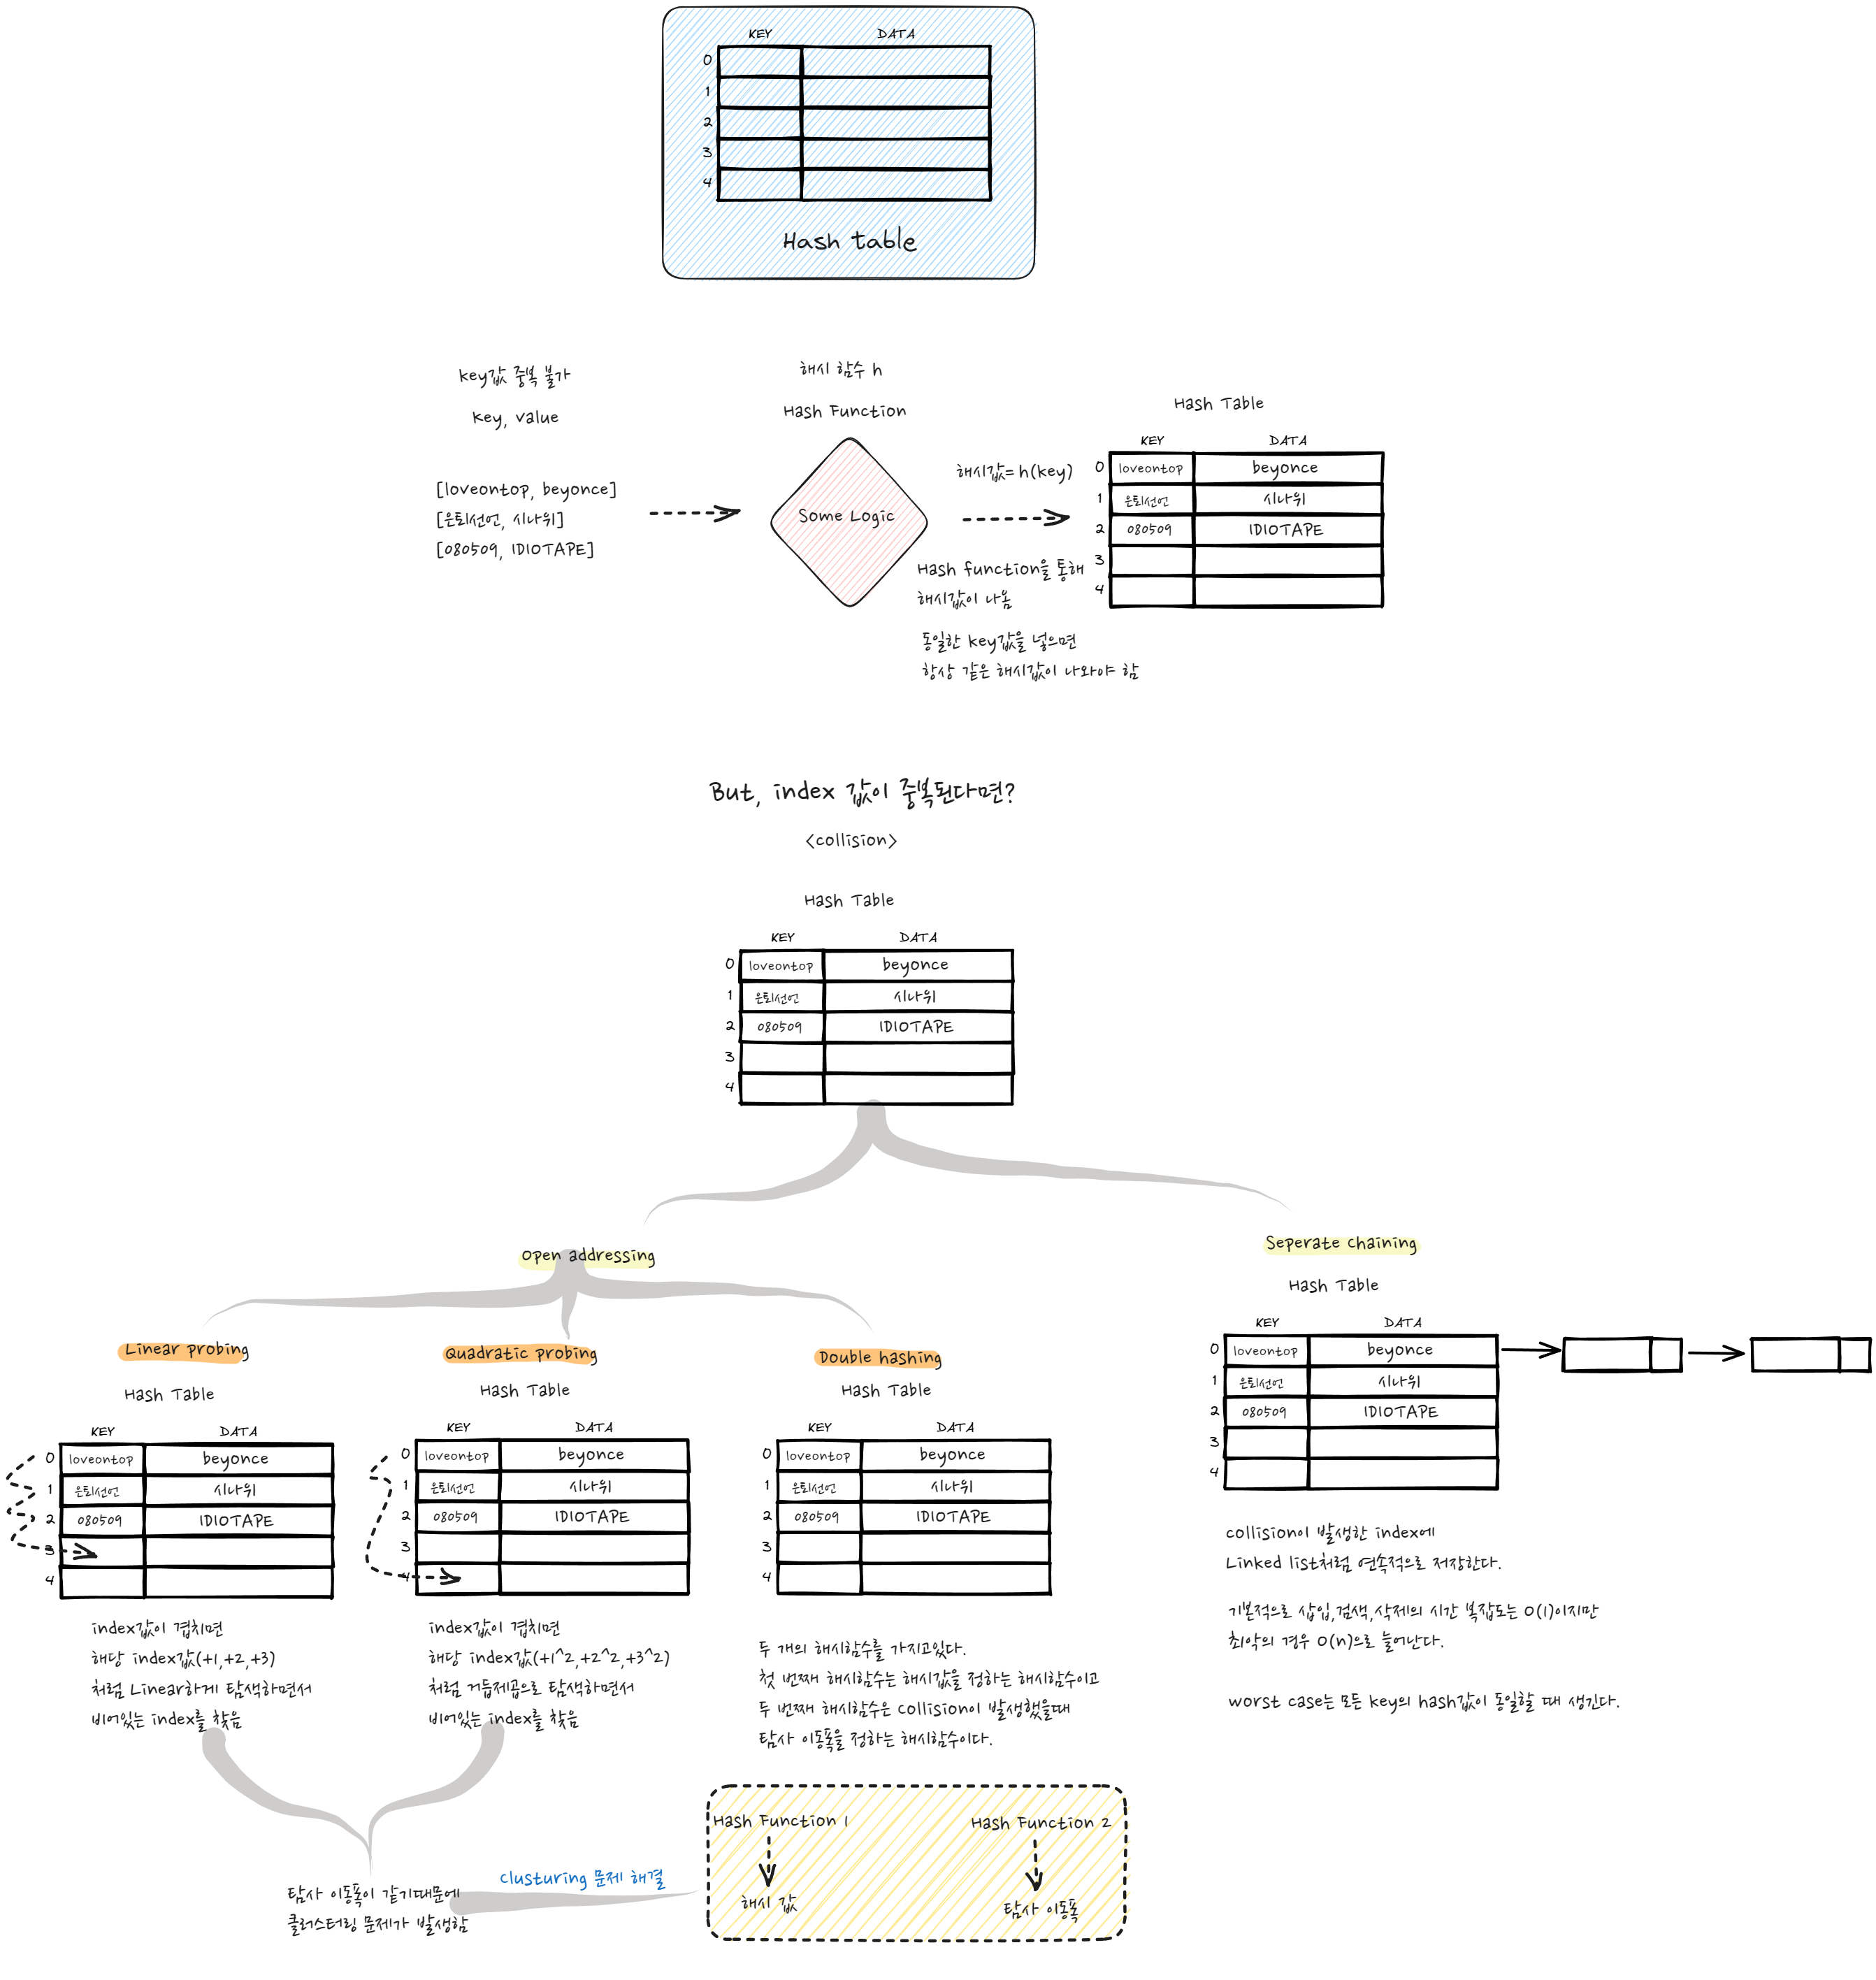
중복되지 않는 key값을 해시함수에 넣어 나오는 해시값을 index로 삼아 key-value 쌍으로 값을 저장한다.
시간 복잡도는 일반적으로 저장, 삭제, 검색 모두 O(1)이나 worst case의 경우 O(n)이 된다.
worst case
collision
- 서로 다른 key값에서 나온 해시값이 동일한 상황
- separate chaining에서 모든 key값의 해시값이 동일하다면 n개의 Linked list가 생성됨 -> 시간 복잡도 O(n)
- open address도 모든 key값의 해시값이 동일하다면 n번 탐색해야 함
collision이 발생했을 때 해결방법
- open address
- Linear probing: 충돌이 발생한 index에서 탐사 이동폭을 선형(+1,+2,+3)으로 가져감
- Quadratic probing: 탐사 이동폭을 제곱수(+1^2, +2^2, +3^2)로 가져감
- Double hashing: Linear/Quadratic probing에선 탐사 이동폭이 동일하기 때문에 클러스터링 문제가 발생. 이러한 문제를 해결하기 위하여 해시함수가 2개 있음. 1개는 key값에 대한 해시값을 생성하는 함수. 두 번째 함수는 collision이 발생했을 때 탐사 이동폭을 구하기 위한 함수이다.
- separate chaining
- 충돌이 발생한 index에서 Linked list의 노드를 추가함
Hash table은 hash function을 통해 빠른 연산 속도를 가져가는 동시에 해시값이 최대한 겹치지 않게 설계해야 한다.
⭐기술면접에 자주 나옴
'etc. > 자료구조' 카테고리의 다른 글
| Binary Search Tree (0) | 2023.10.04 |
|---|---|
| Priority Queue/Heap (0) | 2023.10.04 |
| Stack (0) | 2023.10.04 |
| Queue (0) | 2023.10.04 |
| Array vs Linked list (0) | 2023.10.01 |
최근에 올라온 글
- Total
- Today
- Yesterday